 Evilom
22 KiB
XRMpwLyT6i55YykYcZScuyRWnyh
Source: https://dianchukeji.feishu.cn/wiki/XRMpwLyT6i55YykYcZScuyRWnyh
一.工作内容概述
- 修复碎片收集界面在真机测试过程中出现的“碎片显示异常”、“动画表现异常”问题。
- 确认项目美术概念方向,尝试建立规范,在后续工作流中最大限度保证美术资产的风格一致性,
- Responses API 生图链路验证,UI 生图工作流方案收敛
二.美术概念方向确定
抖音小游戏主流品类与美术风格分析
主玩法品类 代表方向 / 产品 常见美术倾向 核心优势 对项目的参考价值 IAA休闲 / 超休闲 抓大鹅、羊了个羊、拧螺丝、挪车、倒水排序、机关消除类小游戏 明快卡通;图标大而清晰;操作区域突出;道具入口明显;成功、失败、奖励反馈强 用户能快速理解玩法,适合短局体验、广告变现和短视频传播 可以借鉴其短局节奏、提示广告、通关反馈和分享挑战设计,但不能只做成安静的逻辑题界面 二合模拟经营 浪漫餐厅、四季合合、梦幻旅行、家园修复、餐厅经营、百货店经营 温暖治愈;生活化场景;低饱和暖色;角色亲和;UI 圆润;装修、收集、任务反馈较强 长期目标感和留存能力较强,能通过建设、收集、剧情推进维持用户动力 项目本身不是经营玩法,但可以借鉴其长期目标设计 塔防 / 射击 / 割草 向僵尸开炮、猎梦保卫战、生存类小游戏、末日防守类小游戏、割草 like 产品 高对比;战斗感强;怪物密度高;伤害数字和攻击特效明显;短视频素材表现力强 战斗爽感强,成长反馈明确,素材容易剪出刺激点 整体风格不适合项目,但可以借鉴其“强反馈意识” 中重度成长类 放置 RPG、SLG、卡牌、传奇、仙侠、末日生存等 角色立绘、装备、数值成长、基地/阵容/技能表现较重,视觉层级更复杂 付费深度和长期成长空间更强 项目不适合直接参考其美术体量,但可以少量借鉴成就、章节、收集和成长反馈,不应引入过重数值感
最终方向确定
基于前面对抖音小游戏主流品类和美术风格的分析,当前项目最终美术包装方向确定为:小鸡侦探社 该方向的核心并不是单纯将动物形象从“牛”替换为“小鸡”,而是围绕项目本身的逻辑推理玩法,建立一套更容易被用户理解、也更方便后续美术资产持续扩展的主题包装。 项目本质上属于轻益智逻辑解谜玩法,玩家需要根据颜色区域、行列限制、相邻限制等规则,逐步排除错误位置并找出目标。因此,美术包装需要同时满足两个要求: **“小鸡侦探社”**正好能够承接这两个需求:小鸡提供亲和、可爱、低门槛的视觉入口;侦探社提供线索、推理、标记、排除、破案等玩法解释语言。
概念包装
包装定位 当前项目包装定位确定为:一款以“小鸡侦探社”为主题的轻益智逻辑解谜小游戏。 玩家并不是单纯在棋盘中“放置小鸡”,而是作为小鸡侦探社的一员,根据案件中的线索,在分区棋盘里推理出目标小鸡的位置。 整体概念可以概括为:小鸡侦探社每天收到不同案件。玩家需要根据案件规则和线索,在棋盘中找出隐藏的小鸡位置,完成挑战后收集拼图碎片、解锁案件记录与小鸡故事。 这个包装能够将原本偏抽象的逻辑规则,转化成更具主题感的游戏表达。 玩法行为与包装语言映射(例) 玩法行为 包装表达 关卡 案件 棋盘 案件现场 颜色区域 调查区域 / 可疑区域 每个区域 1 只小鸡 每个调查区域都有 1 个目标 每行每列 1 只小鸡 横纵线索限制 小鸡不能相邻 目标不能出现在相邻位置 提示 线索 / 侦探提示 标记 标记可疑点 排除格 排除嫌疑位置 清除 清空推理记录 通关 案件解决 拼图奖励 案件记忆碎片 图鉴 / 收藏 案件档案 / 侦探手账 通过这套映射,玩法不再只是“做逻辑题”,而是变成“根据线索破案”。这能提升主题完整度,也能让用户更快理解提示、标记、排除等功能的意义。 为什么选择小鸡 在动物形象上,最终选择小鸡,主要基于以下原因: 为什么选择”侦探社“的包装 侦探社包装相比普通农场、花园、旅行、拼图日记等方向,更贴合项目核心玩法。 项目的主要乐趣来自:
- 观察规则;
- 判断候选;
- 排除错误位置;
- 根据限制逐步推理;
- 最终找到正确答案。 这些行为天然适合被包装为:
- 找线索;
- 标记可疑点;
- 排除嫌疑;
- 破解案件;
- 完成侦探挑战。 因此,“侦探社”不是额外附加的皮肤,而是对玩法行为的主题化解释。 它能帮助项目避免“可爱但玩法表达弱”的问题,也能避免用户误以为这是普通找茬、农场经营或纯拼图游戏。 包装边界 虽然最终确认使用“小鸡侦探社”,但侦探感需要控制在“轻侦探”层级,不应走向重悬疑或复杂剧情。 包装边界如下: 应该保留 应该避免 放大镜、线索卡、案件章、侦探手账 暗黑案件、恐怖氛围、真实犯罪感 轻推理、轻调查、每日案件 大段剧情、复杂人物关系 可爱小鸡侦探 写实侦探、成人化侦探 拼图收集、案件档案、侦探徽章 重度剧情解谜、沉重悬疑演出 温暖纸张、便签、胶带、印章 暗色高对比、血迹、阴影压迫感 最终要呈现的是:可爱的小鸡侦探社,而不是严肃的侦探悬疑游戏。
美术风格锚定
风格总定义 项目美术风格最终锚定为:2D 手账拼贴风 + 轻侦探包装 + 休闲益智 UI 一句话描述:像一本由牛皮纸、米白纸、便签、胶带、回形针、图钉、印章、拼图碎片组成的小鸡侦探社手账,玩家在其中查看案件、完成推理、收集拼图、解锁档案。 整体视觉需要兼顾三点: 参考图锚定结论 当前已生成并筛选了四类关键界面参考图,分别对应:
- 首页 / 主界面;
- 每日挑战 / 核心玩法界面;
- 拼图收集 / 奖励界面;
- 已收集拼图 / 收藏册界面。
从这些图中可以提炼出后续美术规范的共同特征:
维度
锚定方向
页面比例
竖版 9:16
主视觉
小黄鸡侦探,戴侦探帽,持放大镜
材质
牛皮纸、米白纸、便签、胶带、回形针、纸张折角
装饰
放大镜、案件章、线索贴纸、图钉、拼图碎片
色彩
暖米色、浅棕、奶油黄为主,蓝绿红橙作为功能色
UI形态
圆角纸片按钮、便签卡片、纸质标签、柔和阴影
棋盘
彩色分区清晰,格子规整,X 标记和小鸡格可读
气质
温暖、可爱、轻松、清晰、带轻微侦探感
这些内容应作为后续所有界面和资产生成的统一风格基准。
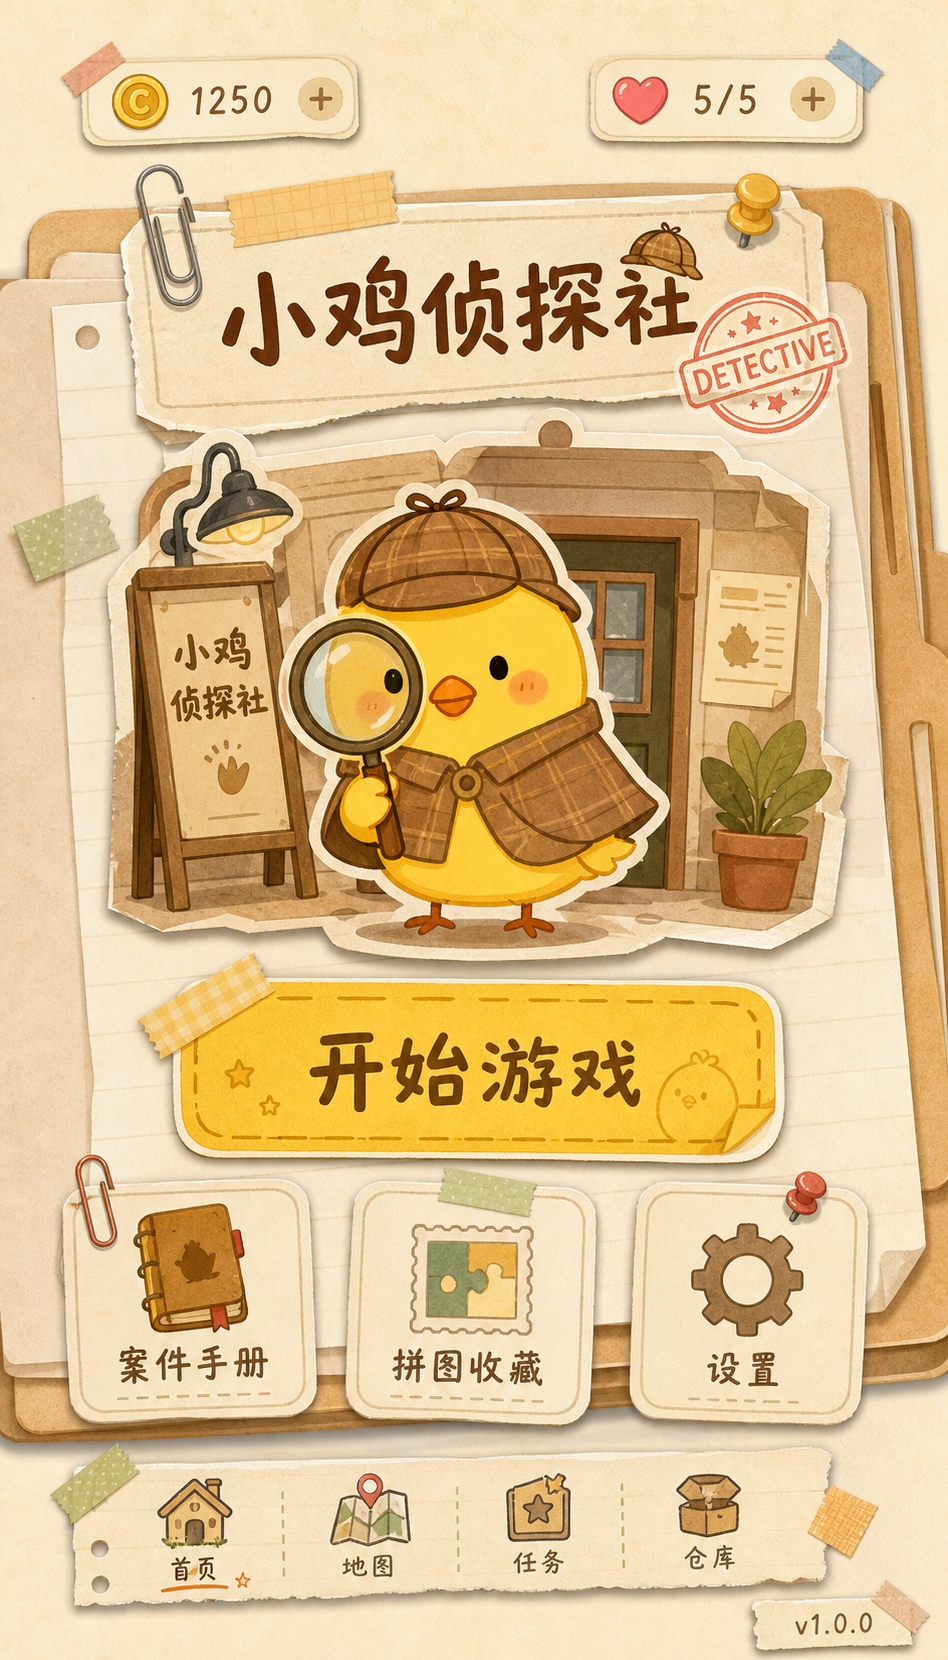


 视觉要素锚定
整体目标是:温暖但不灰暗,可爱但不刺眼,分区清楚但不杂乱。
后续无论是首页、玩法页、拼图收集页、收藏册、弹窗、按钮、活动页还是 asset sheet,都应保持同一套角色特征、纸质材质、棋盘规则和配色逻辑,避免因单个页面重新设计而造成风格漂移。
视觉要素
锚定方向
具体要求
需要避免
核心角色
小鸡侦探
角色统一为圆润、Q版、亲和的小黄鸡;具备黄色身体、橙色嘴巴、黑色豆豆眼、红润脸颊等稳定特征;佩戴棕色侦探帽,可搭配放大镜、小披风、领结、侦探外套等轻量配件;后续可扩展默认、开心、思考、发现线索、推理成功、推理错误、冒汗、得意、惊讶等表情,用于按钮图标、反馈弹窗、通关演出、分享图和奖励卡片。
避免角色风格漂移;避免写实羽毛、3D玩具化、过度拟人化、比例失衡;避免混入牛、猫、兔、鸭等其他动物作为主要角色或主要 icon。
UI 材质
纸质手账拼贴
主要视觉材料包括牛皮纸、米白纸、便签、胶带、回形针、图钉、撕边纸、纸张折角、纸张压纹、柔和投影和侦探印章等;按钮、页签、弹窗、奖励卡、规则卡都应像贴在侦探手账里的纸片或档案卡;需要有纸质感,同时保持清晰的游戏 UI 可点击属性。
避免金属科幻按钮、玻璃拟态、高饱和霓虹、纯扁平无质感或厚重 3D 按钮;避免装饰过多导致界面阅读困难。
玩法棋盘
清晰规则化棋盘
棋盘必须优先服务实际玩法;保持规则化方格结构;不同颜色区域清晰可辨,每个颜色区域代表一个分区;空白格、已排除格、已放置小鸡格需要明确区分;已排除格建议使用清晰 X 标记;已放置小鸡格使用贴纸化小鸡头像或小鸡标记;单元格可有轻微纸张压纹、圆角边缘和柔和立体压边。
避免只做装饰性棋盘;避免格子边界不清;避免颜色区域难以区分;避免将棋盘做成普通插图或拼图图案;避免装饰遮挡棋盘,影响玩家判断。
配色体系
温暖低饱和纸张色
主色使用暖米色、牛皮纸浅棕、奶油白、浅咖色、小鸡黄和侦探帽棕,形成温暖、轻松、柔和的基础氛围;功能辅助色可使用低饱和蓝色、绿色、红色、橙色、紫色、粉色、青绿色;蓝色用于主要按钮、分页或拼图收藏,绿色用于进度、确认和模式入口,红色用于生命值、提醒和新内容标识,橙色用于奖励、挑战和金币,紫色 / 粉色 / 青绿色用于棋盘分区。
避免荧光色、霓虹色、高饱和刺眼渐变、暗黑高反差悬疑色系;避免整体过灰导致不够吸引,也避免颜色过杂影响棋盘可读性。


三.Responses API 生图链路验证与 UI 生图工作流方案收敛
背景概述
今日主要继续围绕 ui-asset-forge 的 UI 生图工作流进行探索,重点验证第三方 provider 的 Responses API 是否能够作为后续 agent 生图流程的核心入口。 之所以希望使用 Responses API,主要是因为它理论上更接近网页版 GPT 的生图交互体验。相比单纯调用 Image API,Responses API 的优势不只是“生成图片”,而是可以在上下文中完成更灵活的任务理解和工具编排,例如:
- 理解用户真实意图;
- 读取并分析参考图;
- 自动扩写和重写 prompt;
- 判断当前任务更适合生成还是编辑;
- 在同一上下文中结合文本、图片和历史信息;
- 调用生图工具快速输出结果;
- 在 agent 内部形成更自然的多轮调整流程。 如果这条链路可用,ui-asset-forge 就可以将“用户需求理解 → 参考图分析 → prompt 生成 → 生图调用 → 结果修正”整合进一个统一 agent 流程中,从而最大限度接近网页版的生图体验,并提升整体交付效率和生成质量。 不过,之前的测试中已经发现,第三方中转站 Responses API 直接作为生图入口时,并没有比 Codex 原生 imagegen 带来明显速度优势,反而增加了接口接入、稳定性和维护成本。因此之前的阶段性判断是:继续围绕 Codex 原生 imagegen 优化 asset sheet 合批策略和本地切图脚本。 今日在此基础上继续深入验证:第三方 Responses API 是否真的无法作为统一生图入口;如果无法满足预期,是否可以将其降级为理解层,再配合专门的 Image API 形成更稳定的工程化方案。
之前结论的承接与补充
之前日报中曾将 Codex 原生 imagegen 作为后续 Skill 主流程基础,这一判断是基于当时测试范围得出的阶段性结论。当时重点验证的是:
- 中转站 Responses API 是否可以直接替代 Codex 原生 imagegen,作为一个更接近网页版体验的统一生图入口。 测试结果显示,中转站 Responses API 在接入成本、稳定性和实际交付速度上都没有明显优势。因此,当时判断继续围绕 Codex 原生能力优化 asset sheet 合批、本地切图和 manifest 流程,是更现实的提效方向。 结合今日测试,找到的两个中转站的GPT Response API并不能像官方支持的那样同时将prompt和参考图片在同一个请求内发出,且多轮上下文的调用方案也确定无法使用。这也一定程度上说明了为什么先前的测试结果那么不理想。 今日的测试中,进一步拆分了问题:
- 之前主要验证的是:Responses API 能不能直接作为统一生图入口
- 今日验证的是:Responses API 如果不能直接生图,能不能作为理解层;生图部分是否可以交给 Image2 接口完成。 新的测试结果表明,第三方 Responses API 可以作为分析、规划、prompt 扩写的理解层使用。真正的图片生成,则可以降级到 gpt-image-2 的 /v1/images/edits 端点完成。
两个平台的 API Provider 测试结果
今日主要测试了两个 provider:
- api.ikuncode.cc
- api.apiyi.com 测试重点包括:
- Responses API
- prompt + 图片输入组合
- Responses + image_generation
- previous_response_id 多轮上下文
- gpt-image-2 / gpt-image-2-vip
- /v1/images/generations
- /v1/images/edits
Responses API 测试情况
两个 provider 的 Responses API 在基础文本请求上均可以正常响应,部分模型也可以完成一定程度的图片理解任务。但在 ui-asset-forge 真正需要的核心链路中,测试结果不理想。 理想链路是:
- 【用户 prompt + 参考图 + Responses 上下文理解 + image_generation 工具调用】 → 直接输出图片 实际测试中,两个 provider 都无法稳定满足这条链路。主要表现为:
- 无法在 Responses API 中同时携带 prompt 和参考图,并继续完成后续生图;
- tools: [{ type: "image_generation" }] 无法正常工作;
- tool_choice: { type: "image_generation" } 无法得到可用图片输出;
- 部分请求返回 400 invalid_request_error;
- 部分请求出现超时或服务端兼容问题;
- 即使切换到更高规格模型,也没有解决该问题。 推测原因主要有三点: 因此可以判断,当前第三方 provider 的 Responses API 并不能完整复现官方或网页版中“理解 + 工具调用 + 生图”的一体化体验,暂时不能作为 ui-asset-forge 的统一生图入口。
previous_response_id 多轮上下文测试情况
除了 prompt + 图片 + 生图工具链路外,今日也测试了 previous_response_id 是否可以作为稳定的多轮上下文机制。 测试方式是: 实际结果中,多次出现:previous_response_not_found 推测原因可能是:第三方 provider 虽然兼容了 /v1/responses 的请求格式,但没有完整保留官方 Responses API 的服务端状态管理机制。也就是说,请求可以返回 response id,但该 id 未必会被长期保存,或者不同请求之间没有进入同一个可续接的会话存储系统。 另外,也可能存在中转层状态隔离、请求路由不一致、缓存过期时间极短等问题。比如第一轮请求被路由到某个后端节点,第二轮携带 previous_response_id 时被路由到另一个节点,而后者无法找到上一轮 response 状态。 因此,previous_response_id 在当前 provider 环境下不适合作为稳定的多轮上下文机制。
图片生成端点测试情况
在确认第三方 Responses API 不能承担统一生图入口后,继续测试了图片 API 作为降级方案。 其中,api.apiyi.com 的 /v1/images/edits 端点表现相对可用,尤其是 gpt-image-2-vip 可以完成:
- 参考图生成;
- 图生图;
- 概念图生成;
- asset sheet 生成;
- 多轮调整;
- 单元素补图。 相比之下,/v1/images/generations 在当前测试环境中表现不稳定,出现路由到 dall-e-2 或模型不可用的问题,因此暂时不适合作为主链路。 推测原因是,/v1/images/generations 和 /v1/images/edits 在 provider 侧可能不是同一套路由配置。generations 端点可能仍然沿用了旧的 DALL·E 路由或默认模型映射,而 edits 端点已经正确接入了 gpt-image-2-vip。因此在当前账号或当前 provider 配置下,edits 端点比 generations 更可靠。 另外,gpt-image-2-vip 本身更接近对话式改图或参考图生成场景,因此它在“参考图 + prompt → 新图”的任务中表现更好。但它并不是严格意义上的原图切片工具,而是会基于参考图重新构图,因此后续仍需要通过更强的 prompt 约束和 asset sheet 清单来提高可控性。 最终较稳定的降级方案是:
- Responses API:负责图片理解、用户意图分析、结构拆解、prompt 生成
- Image2 edits:负责真正的图片生成、图生图、asset sheet 输出 也就是将原本希望由 Responses API 一次完成的事情,拆成两个阶段: 这条链路虽然不如理想中的 Responses + image_generation 一体化,但目前更稳定,且实际生成效果更接近预期。
降级方案验证:Responses 分析 + Image2 Edit 生图
第一轮:使用 Responses API 分析界面
第一轮使用 Responses API 对参考 UI 截图进行分析,重点提取:
- 界面整体结构;
- 顶部、中部、底部区域划分;
- 主视觉位置;
- 功能入口布局;
- UI 材质和风格;
- 可拆分资产;
- 普通文字和艺术字的区别;
- 后续 asset sheet 的拆分方向。 这一步效果比较理想,说明 Responses API 虽然不适合直接生图,但适合作为理解层,用来完成参考图分析和生成规划。
第二轮:使用 Image2 Edit 结合参考图生成图片
第二轮使用 gpt-image-2-vip 的 /v1/images/edits 端点,结合第一轮得到的分析结果和参考图进行生图。 该流程在效果图生成方面表现较好,能够较大程度还原参考图的风格、布局关系和视觉层级。 不过也发现,edits 端点并不是严格意义上的“原图切片”或“逐像素编辑”,而更像是参考图驱动的重新生成。因此,如果要用于 asset sheet 生成,需要在 prompt 中加入更强的清单约束,例如:
- 哪些元素必须单独输出;
- 哪些元素不能合并;
- 普通文字不要输出;
- 艺术字需要单独输出;
- 图标和底板是否分离;
- 每个元素之间必须留出空白;
- 输出结果要方便后续切图和抠图。 这说明后续正式接入时,需要让 ui-asset-forge 在生图前先生成更明确的 asset list 和 sheet plan,而不能只依赖模型自由理解截图。
测试结果


仍存在的问题
从阶段性结果看,第三方 provider 方案可以稳定完成多张 sheet 的生成,且在速度和批量生成方面优于 Codex 原生流程(支持并发请求)。但仍然存在一些问题:
- 复杂 UI 的元素容易被合并;
- 部分资产边界不够清晰;
- 标题 Logo 等复杂元素拆分效果不稳定;
- 部分元素仍然需要多轮调整; 推测原因是,asset sheet 本质上是一个“多目标生成任务”,要求模型在同一张图里同时保持风格一致、元素独立、比例合理、边界清楚和便于切图。这与普通效果图生成不同,普通效果图只要整体视觉成立即可,而 asset sheet 要求每个单独元素都具备可交付性,多个要求的叠加会分摊掉模型的注意力,导致部分内容无法满足需求。 同时,edits 端点会倾向于根据参考图重新组织画面,而不是机械地复制和拆分原图元素。因此当参考界面比较复杂时,如果 prompt 中没有足够明确的清单约束,模型容易把图标、底板、装饰和文字重新组合,导致资产边界不清或元素混合。 因此,后续仍需要制定更加详细精确的切图资产列表和提示词,来尽可能减少返工的概率。
对比 Codex 原生流程
今日也尝试了 Codex 来执行相同的链路,从测试结果看,Codex 原生流程在效果图生成方面表现较好,但在 asset sheet 批量生成、单元素还原质量、成本拆分和工程可控性方面,仍弱于第三方 provider 方案。
效果图生成对比
对比项
Codex 原生流程
第三方 Provider 方案
结论
参考图理解
能够较好理解参考图内容、结构和风格
通过 Responses API 也可以完成参考图分析
两者在理解层效果接近
风格迁移
效果较好,能够接近参考图的整体风格
使用 Responses 分析 + Image2 edits 后,也能获得接近效果
效果图阶段差距不大
结构还原
能够还原主要布局和视觉层级
结合参考图和分析描述后,结构还原也较好
两者都适合效果图验证
生成体验
更接近自然对话式生成,适合边聊边改
需要 agent 编排 provider,但用户侧也可以封装成统一体验
Codex 更轻便,provider 更工程化
适用场景
风格探索、包装方向验证、效果图生成
概念图生成、正式生产前的效果确认
两者都可以用于前期探索

