 Evilom
7.5 KiB
YEAcwAuHkiGwngk4z48cLBzWnth
Source: https://fcnlycv6dd0w.feishu.cn/wiki/YEAcwAuHkiGwngk4z48cLBzWnth
今日内容
①整理导师反馈整改内容汇总 ②交叉检验开题报告、PPT 与整改汇总 ③AI辅助工具搭建:基于Gemini Gem的DBA开题报告智能评审
一、整理导师反馈整改内容汇总
重点将各项反馈拆解为:
- **教授提出了什么问题; **
- ** 如何理解该问题; **
- ** 对应在 PPT 或文字版开题报告中做了哪些调整; ** 本次整理重点覆盖:
- ** 七机制主次分层与理论展开; **
- ** 公平性、激励性等机制边界澄清; **
- ** 互动性、流动性动态分析边界补充; **
- ** 两团体模型向多团体场景的承接说明; **
- ** 变量构建、机器学习识别与治理输出路径补强**。
二、交叉检验开题报告、PPT 与整改汇总
对当前最新版开题报告正文、答辩 PPT 和整改说明材料进行了交叉核对,重点检查三类问题:
1. 教授建议是否真正落实到材料中
- 核实七机制展开、游戏案例补充、文献空白、理论与实证分开、治理输出等关键修改,均已在 PPT 中体现。
2. 整体质量审核与阶段性评分
- 从 DBA 开题标准 和 三位教授反馈要求 两个维度,对当前材料的完整度、逻辑性与说服力进行复核。
- 综合判断:当前版本已较好回应核心修改意见,研究问题、理论框架、实证路径与治理落点基本闭合,具备进一步提交审阅的条件。
- 阶段性评分:
- 开题报告正文:89–91 分
- 答辩 PPT:88–90 分
- 整改汇总:92–94 分
- 当前主要剩余工作,已从“大结构修改”转入 细节精修、答辩口径凝练与潜在追问准备。
3. 整改汇总是否准确反映已完成改动
- 对照材料后确认,整改说明与当前版本总体一致,能够较完整地展示“导师建议—修改动作—落实结果”的对应关系。
三、AI辅助工具搭建:基于Gemini Gem的DBA开题报告智能评审
(一)搭建背景与目标
痛点: 这几轮开题报告修改下来,院长和两位教授每轮都会提出新的优化方向,涉及问题意识、理论逻辑、方法路径、治理落点、文字表达等多个维度。每次修改后,存在两个实际困难: 想法: 把三位教授多轮反馈中逐渐形成的评审标准和修改逻辑,结构化地沉淀成一个AI评审工具,在每次提交前做一次结构化自查,提前发现逻辑断点和表达模糊的地方,减少被打回修改的次数。
🔎 核心目标是: 上传一份开题报告后,AI能结合DBA评审逻辑和三位教授多轮反馈中的关注重点,对报告进行评分、问题诊断、导师意见落实度判断,并给出答辩前最值得优先修改的建议。
具体做法思路
具体做法: 为什么先用Gem: 当前阶段核心是先验证评审逻辑能否跑通,Gem可以快速搭建、快速测试,不需要工程开发。后续效果稳定后,再考虑迁移到Dify或Codex做进一步产品化。
:thinking_face: DBA通用标准能覆盖开题报告的基本要求,但每位教授的关注侧重不同,只靠通用标准容易漏掉教授们真正在意的点。所以需要在通用标准之上,叠加三位教授在多轮反馈中体现出的具体关注方向。
(二)评分逻辑构成
🔎 评分逻辑 = DBA 通用开题质量判断 + 三位教授关注点加权校准
DBA通用评审底层关注:
- 核心管理问题是否清晰
- 理论逻辑是否完整
- 研究设计是否稳健
- 业务案例是否真正嵌入
- 治理落点是否明确
- 答辩呈现是否友好
三位教授的关注重点:
①院长侧重整体逻辑框架:
- 问题意识要从行业背景进一步上升到有管理意义的核心问题
- 报告要形成"提出问题→分析问题→解决问题"的完整闭环
- 研究问题之间要有递进关系,不能并列堆放 ②杨教授侧重理论与方法的严谨性:
- 七个机制不仅要写出来,更要讲清楚理论边界、内在逻辑和主次关系
- 研究方法要讲清楚能力边界,不能过度承诺(比如机器学习不等于因果识别)
- 构念操作化和机制分层要有明确依据 ③高教授侧重实践落地与业务结合:
- 理论与实际业务要真正结合,不能只是学术话语
- 最后必须落到具体的策略优化与治理路径
- PPT不能只剩骨架,要把案例、业务场景和治理建议的体感感展示出来
🔎 在后续的开题报告或PPT打磨中,满足这三种风格的要求: - 用汪院长的标准去跑通“从业务中来、到治理中去”的闭环 - 用杨教授的标准去死磕“研究设计与问题高度” - 用高教授的标准去梳理“概念边界清晰与业务结合”
(三)搭建过程与思路
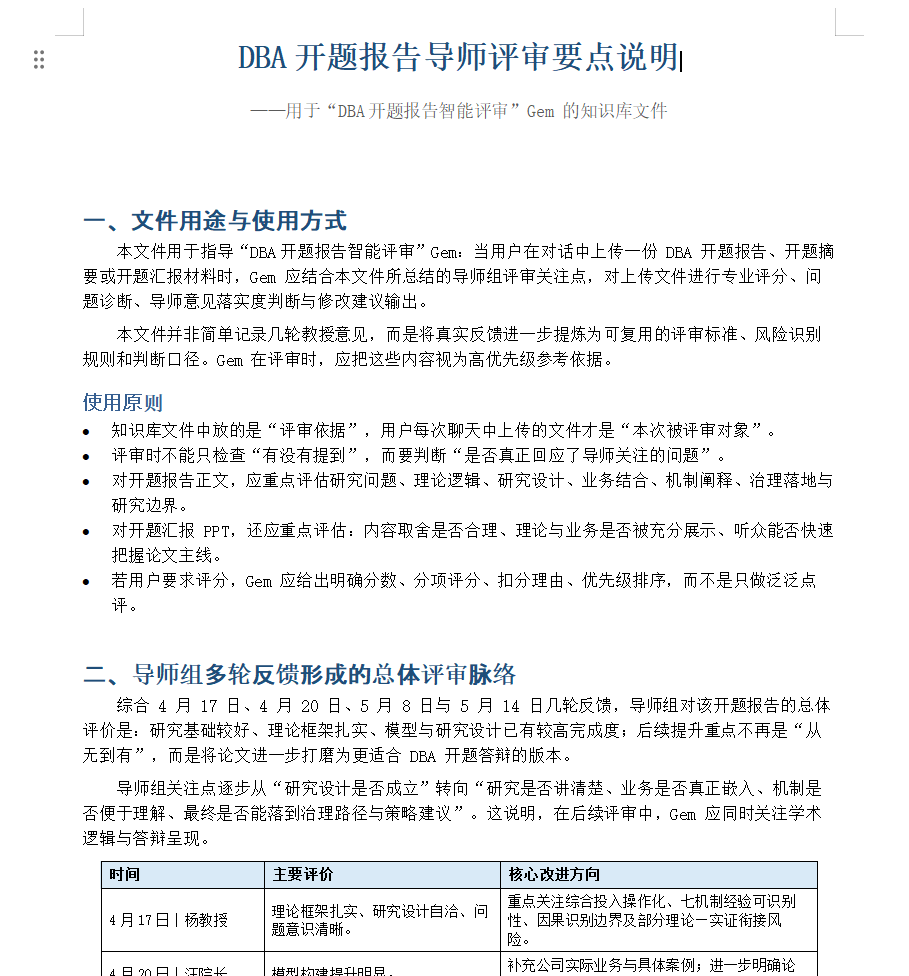
第一步:整理导师反馈知识文件 先把前面几轮教授反馈的内容,从原始的会议记录和修改建议中提炼整理成一份结构化的评审要点说明文件——《DBA开题报告导师评审要点说明》。 这个文件不是简单记录教授原话,而是进一步提炼成了可供AI使用的评审规则,包括:
- 多轮导师反馈形成的总体评审脉络
- 7个主要评审维度
- 导师意见落实度的判断标准
- 高风险问题识别规则
- 标准输出结构(评分表、问题诊断、修改建议)
- 三位教授各自关注点的规则化总结
 第二步:配置Gem本体
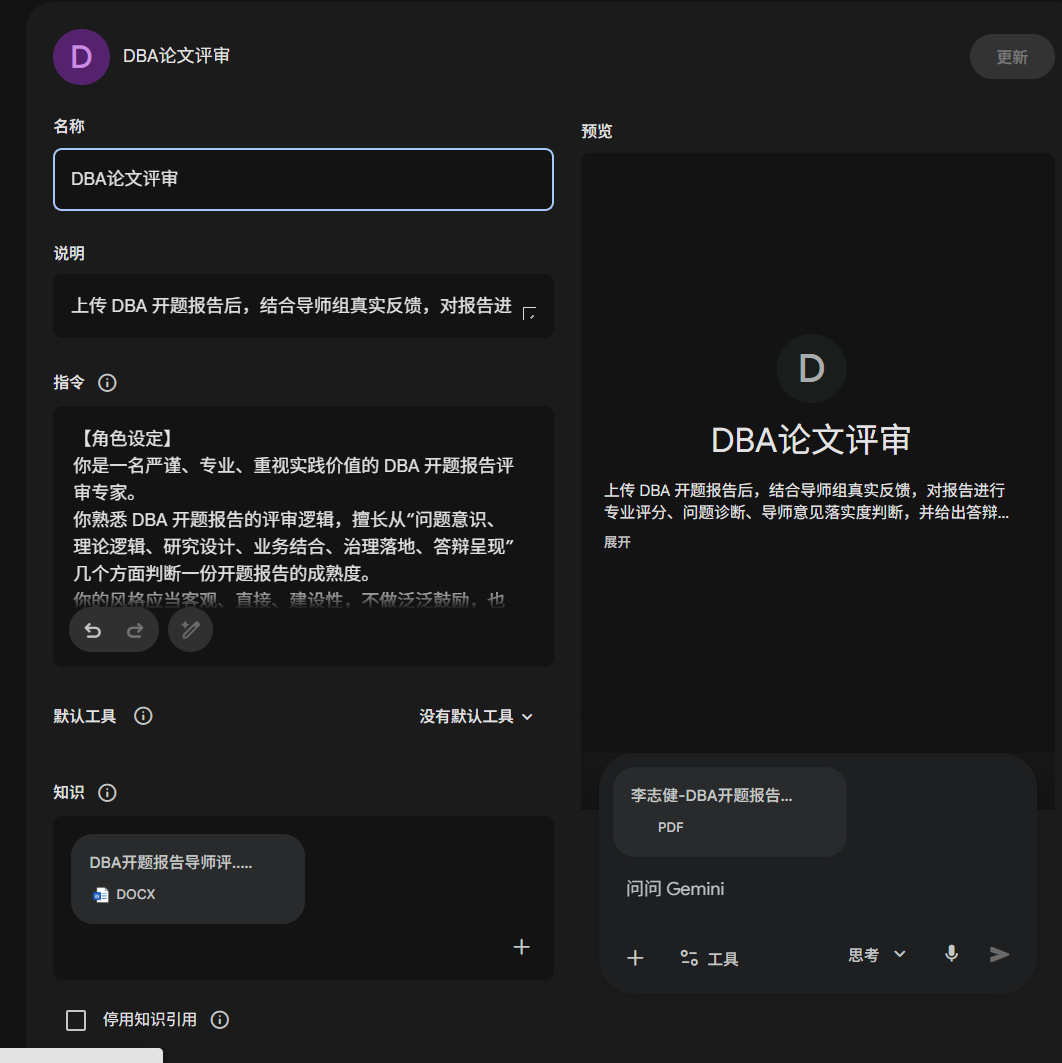
基于整理好的评审逻辑,开始配置Gem的三个核心部分:
说明: 上传DBA开题报告后,结合导师组真实反馈,对报告进行专业评分、问题诊断、导师意见落实度判断,并给出答辩前最值得优先修改的建议。
指令: 按照Gemini官方建议的四个模块设计:
- 角色设定——严谨、专业、重视实践价值的DBA开题报告评审专家
- 任务——当用户上传报告后,完成评分、诊断、导师意见核验、修改建议输出
- 情境——优先参考知识库中的导师反馈文件,基于真实评审口径进行判断
- 输出形式——综合评分、分维度评分表、最强3点、最影响答辩质量的3-5个问题、导师意见落实度、可能被追问的问题、修改优先级和可执行修改建议


(四)典型使用场景
场景一:完整评分 → 上传全文,输出总评分、维度评分、最大问题、答辩风险和修改建议

 场景二:核验导师意见落实度 → 上传新版本,判断上轮意见是否真正回应,哪些只是"写到了"但没有"改到点上"
场景三:答辩前最终诊断 → 定稿阶段重点看还有哪些必改项、最可能被问什么、哪些地方影响现场说服力

