 Evilom
5.0 KiB
Laj9wMQUkivy2okCvUZcSBrenFe
Source: https://ocnmca6f1o0p.feishu.cn/wiki/Laj9wMQUkivy2okCvUZcSBrenFe
工作内容概述
1、财务取数工具配置表驱动模版化 2、部门周会
一、配置表驱动模板化方案
将原有硬编码 Python 脚本架构,全面重构为配置表驱动 + 模板渲染轻量化架构。彻底拆解代码中散落的工作表名称、行列坐标、会计科目、SUMIFS 计算公式、报表展示顺序等零散硬编码逻辑,全部统一迁移至配置表集中维护,实现业务与代码解耦。 同时明确三方职责边界,形成标准化分工体系:
- Excel模板:仅负责报表可视化呈现,统一管控报表样式、表头格式、命名区域定义,聚焦「页面长什么样」
- 配置表:负责核心业务规则定义,涵盖科目清单、报表项目、公式类型、数据取数口径,聚焦「报表生成什么」
- Python脚本:仅作为规则解释执行器,固定执行「读取配置→定位模板区块→批量填充公式」逻辑,不再承载业务规则,聚焦「按规则落地执行」
今日落地进度
严格按照定版重构方案,完成全流程5个阶段迭代,顺利通过端到端全量验收,核心落地成果如下:
预计价值与收益
报表科目调整、项目增减、展示顺序优化、常规口径微调等日常变更,无需修改代码、无需开发介入,财务人员可直接通过编辑配置表自主完成,大幅提升业务迭代效率。
拆解原有Step 2零散硬编码业务逻辑,实现规则统一集中管理。新增报表、调整数据口径的工作模式从「修改代码、测试发布」,简化为「新增/修改一行配置」,迭代成本大幅降低。
摒弃零散字符串拼接公式的粗放模式,统一采用公式白名单机制,所有计算公式标准化、可校验、可追溯,彻底规避手写公式、代码散落导致的口径混乱、公式错误等问题。
保留原有Step 4压缩包注入逻辑,openpyxl仅负责公式填充,不触碰透视表等原有成熟模块,完全规避文件二次编辑导致的格式错乱、数据丢失等往返破坏问题,最大化复用既有产物。
首次建立可落地、可校验的硬性验收基线,明确公式对齐、工作表完整性、异常预警分类等量化验收标准,彻底解决以往「主观判断、模糊验收」的问题,保障交付质量稳定可控。

二、财务数据校验(思路)
目的是打破以往数据流转的“黑盒”状态,把底层逻辑变成一份财务人员能直接看懂的体检报告。它直接回答日常对账中最关心的四个问题:哪里不对、差多少、为什么、下一步去哪查。 为了贴合财务的阅读习惯,报告按逻辑深度拆分为 5 张工作表:
** 解决的业务痛点**
- 告别黑盒排查:以前工具跑完只有结果没有过程,出了差异财务只能找开发翻代码查逻辑,现在取数过程完全透明化。
- 隐性问题显性化:像底稿缺失、项目没做映射、取数规则没命中这类以前极难发现的问题,现在能直观抛出。
- 纯业务语言提示:彻底屏蔽代码里的 traceback、exception 等技术报错,全量转化为财务能懂的业务语言
三、数据源了解
整体财务流水线由技术团队与研究部前后分段承接,双方的核心分工与边界如下:
技术团队:聚焦前半段流程
- 核心职责:负责应收、应付相关业务逻辑线的梳理与系统打通。
- 业务定位:做好财务数据的上游基础搭建与系统对接,确保源头数据通路顺畅。
研究部:聚焦后半段流程
- 核心职责:负责财务数据的汇总与整理,将提取后的子表自动汇总生成总表及各类分析报表。
- 业务定位:承接上游数据,完成最终的报表可视化呈现与财务深度分析。
四、一键自动化流水线
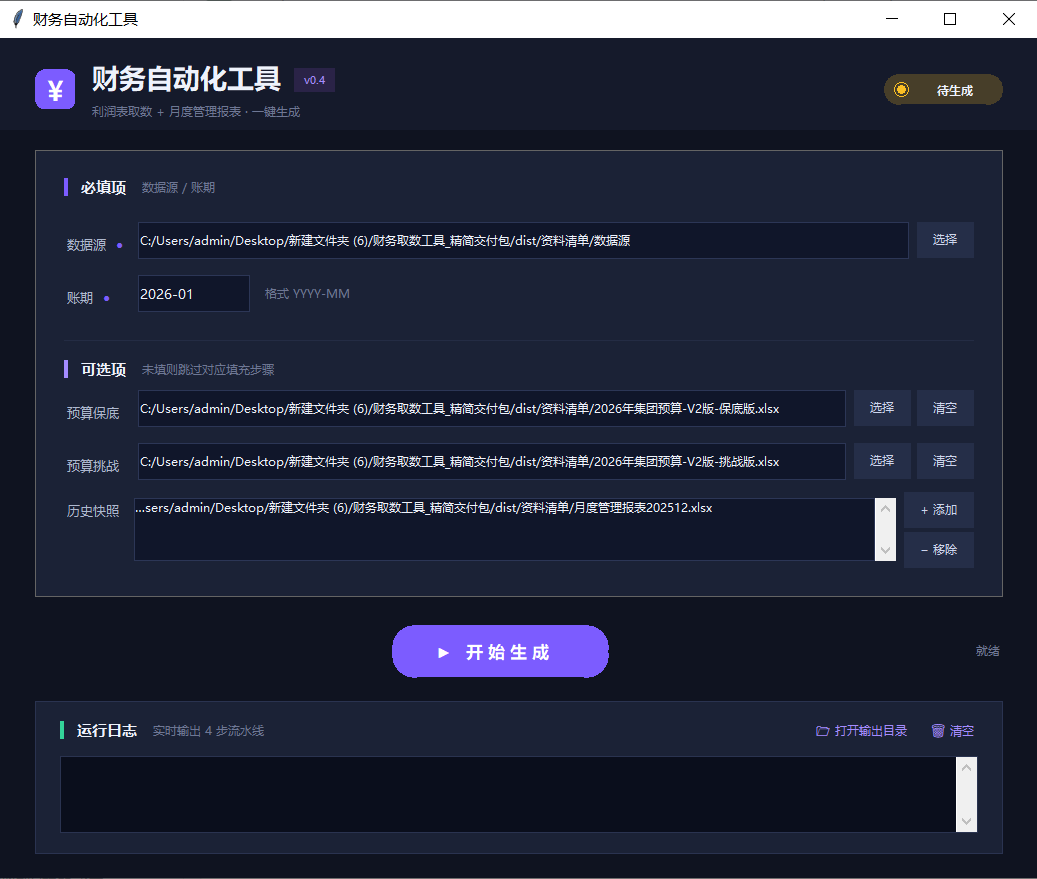
- 一键式操作串联:之前报表生成的三个核心步骤是相互独立的,需要分步手动操作。本周我把整套流程串联整合到了UI界面,实现一键式操作。业务方后续只需要在界面点一下按钮,就能自动完成底层底稿取数、数据汇总、最终月报生成的全流程,全程无需人工干预。
- 格式精准优化:新增了数据合并模块,能够精准把源数据匹配填入报表模板对应位置。另外对空白模板做了精简优化,让最终输出的报表格式、结构和官方样板完全一致,杜绝格式偏差问题。

后续计划:
为取数生成过程的黑盒感,后续将探索数据校验与差异追踪,能够快速定位取数规则、底稿数据和最终结果之间的偏差。 财务同事用实际数据源试跑并收集反馈,然后根据反馈完善规则及优化处理