 Evilom
14 KiB
14 KiB
ExYndBzwSoEobXxqgiicDkionnh
Source: https://dianchukeji.feishu.cn/docx/ExYndBzwSoEobXxqgiicDkionnh
一、工作内容概述
二、AI研究工作流与产品认知资产库搭建推进
(一)今日迭代内容
原定开发计划包括: **AI 研究工作流跑通了从飞书原始资料读取到本地结构化、规则分类、资产候选 review 的基础闭环。**相比此前依赖人工导出、人工整理、人工复制资料,当前已经形成了更可复用的自动化底座,为后续将历史日报、会议纪要、专题研究沉淀为可复用知识资产提供了基础 飞书原始资料 - user OAuth 读取 - 本地 Markdown 镜像 - 正文结构化 - 规则分类 - 资产候选 - 人工 review
Feishu MCP Server 今日实际迭代内容
- source user OAuth:当前读取组织1原始资料的主路径
- tenant token:路径保留,但不是当前主路径
说明:
- 原本预期是通过 source App 的 tenant token 读取组织1资料,但实际验证后发现,组织1中的日报和历史资料主要是共享给我个人账号的,source App 的 tenant_access_token 并不会自动继承我个人账号对这些文档的阅读权限
- 本次完成了 source App 权限、OAuth redirect_uri、user token 缓存、安全忽略等相关配置,并跑通了 source user 授权链路
- 权限配置完成后,继续进行了 live smoke test。完成了从飞书搜索、读取、同步到本地的真实链路。已验证能力包括:
- searchDocs:可搜索真实飞书日报/报告
- getDocContent:可读取 docx 正文
- syncDocs:可将文档同步为本地 Markdown
- manifest:可记录同步文档列表与路径信息
- data 产物:未进入 Git,符合安全边界
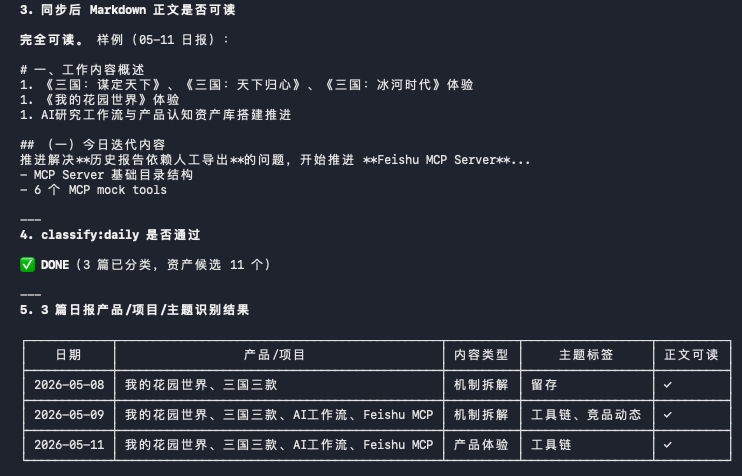
- 在同步过程中发现,部分文件由于飞书返回的 updated_time 不可靠,会导致文件名前缀出现:1970-01-01_...,影响后续按日期索引、日报排序、增量同步和周/月汇总
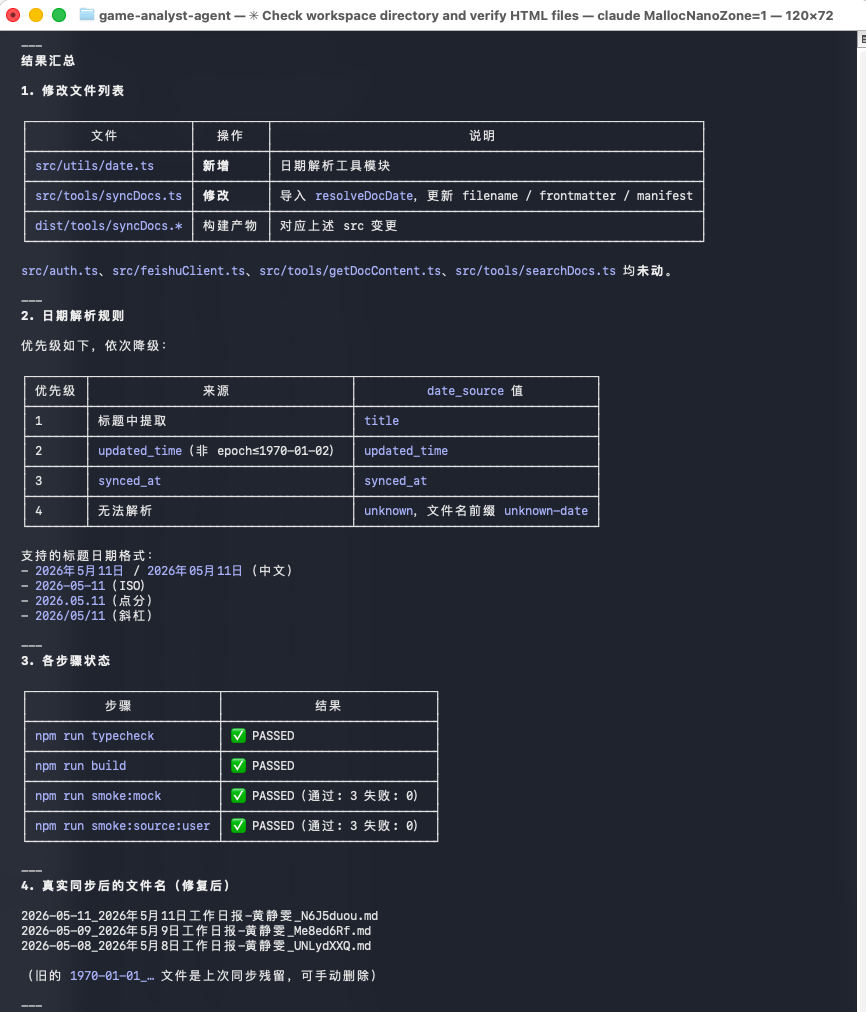
- 已完成日期解析修复,当前日期优先级调整为:
- 优先从标题中解析日期
- 其次使用飞书 updated_time / modified_time
- 再 fallback 到 synced_at
- 最后才标记 unknown-date
修复后,同步文件名已能正确生成类似:
2026-05-11_2026年5月11日工作日报-黄静雯_...
2026-05-09_2026年5月9日工作日报-黄静雯_...
2026-05-08_2026年5月8日工作日报-黄静雯_...
- 初版 Feishu MCP 虽然能读取飞书文档,但正文仍然主要是 block stub,无法支撑有效分类和资产候选识别。继续补齐了 docx blocks 到 Markdown 的转换能力,使同步内容从“可读取”进一步变成“可分析”
- 当前 blocksToMarkdown 已支持常见文档结构,包括:
- 标题
- 段落文本
- 加粗 / 斜体 / inline code
- 无序列表
- 有序列表
- 引用
- 分割线
- 图片占位
- 表格 / 嵌入表格占位
- grid / column 等容器递归
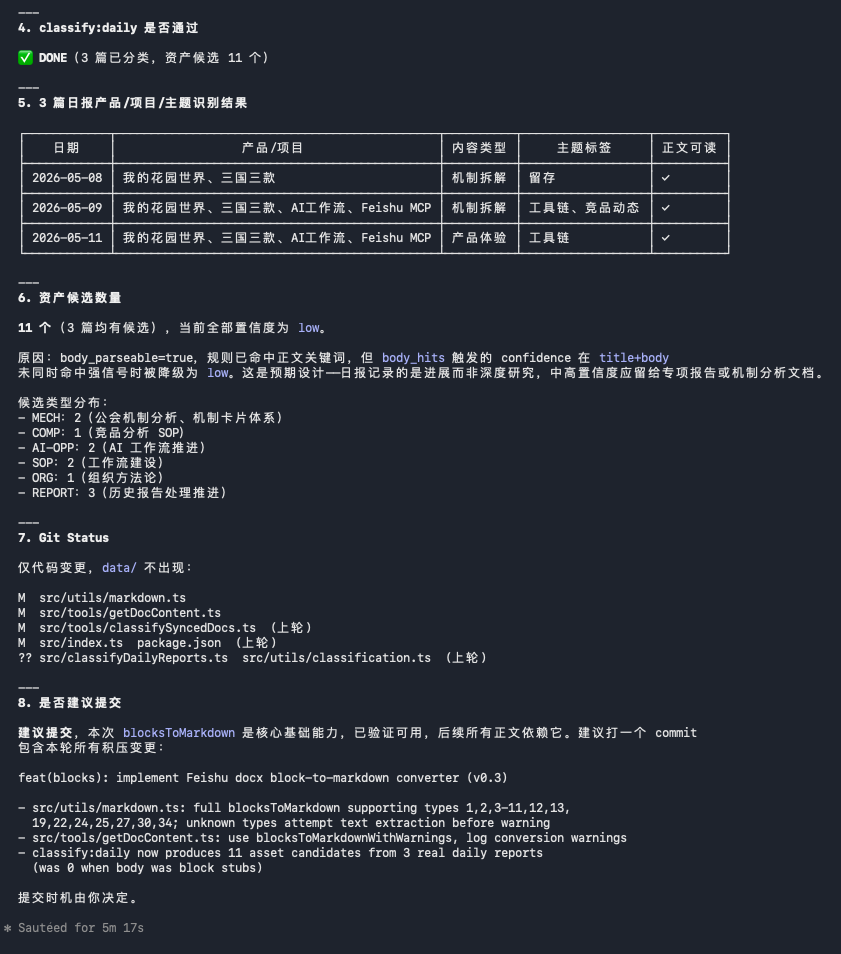
- 在本地 Markdown 同步和正文解析基础上,完成了 v0.3 规则版日报自动分类与资产候选模块。目标不是自动把内容写入知识库,而是先把可能有价值的内容整理成人工 review 清单,降低人工筛选成本
- 输入:
- 本地已同步的 Markdown 日报 / 报告 / 会议纪要
- 输出:
- classification JSON
- asset candidates Markdown
- 识别能力包括:
- 产品 / 项目识别
- 内容类型识别
- 主题标签识别
- MECH / COMP / SOP / ORG / REPORT / AI-OPP 等候选类型
- confidence
- evidence_snippets
- review_required
- 输入:
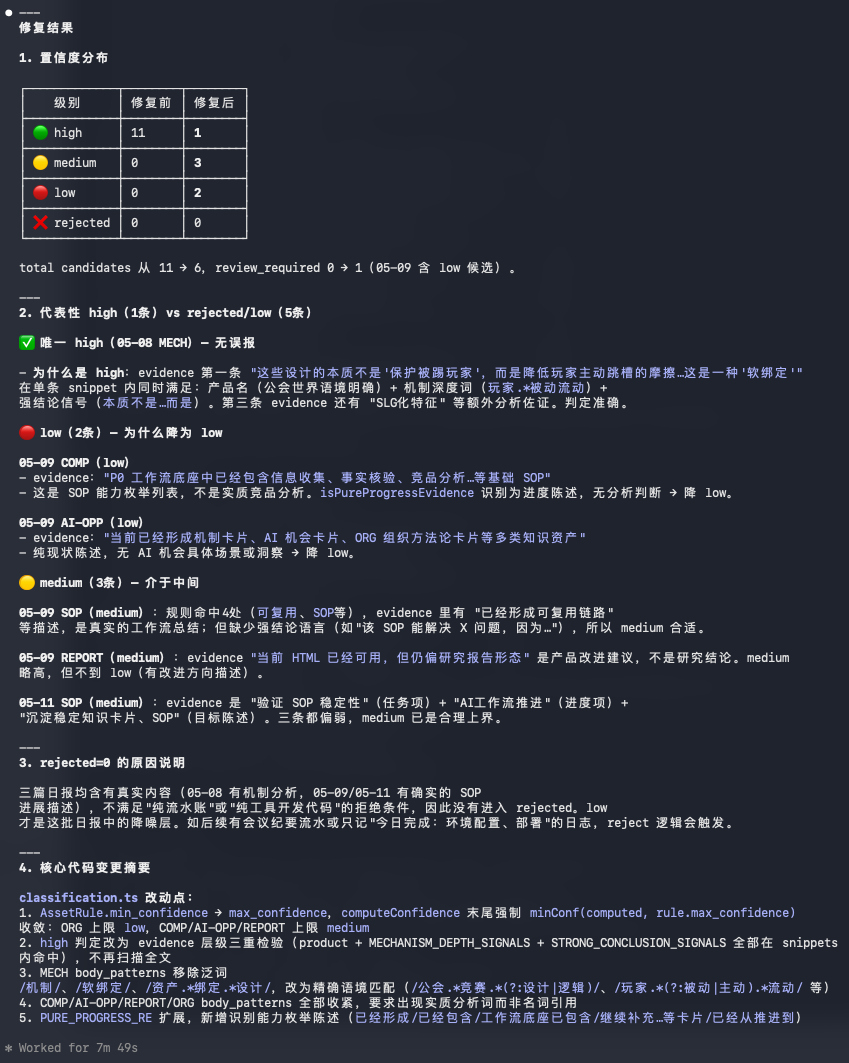
- 重点优化候选置信度与人工 review 可读性,使系统从“能发现线索”推进到“能辅助人工判断哪些内容值得沉淀”。主要改动包括:
- 增加 confidence_reason
- 增加 review_reason
- 增加 rejected_candidates
- 收紧 high 判断
- 引入 high / medium / low / rejected 分层
- 降低泛日报内容、工具流程记录、会议流程内容的误判
- 增强长篇会议纪要中的机制识别能力,主要优化包括:
- 增加段落 / 主题级机制扫描
- 扩展机制主题词
- 支持职业系统、赛季机制、战斗系统、GVG、付费结构、ROI、屯兵、组织生态等机制主题
- 允许长篇会议纪要同时生成 REPORT 与 MECH 候选
- 避免“会议 / 纪要”本身误触发 MECH
说明:
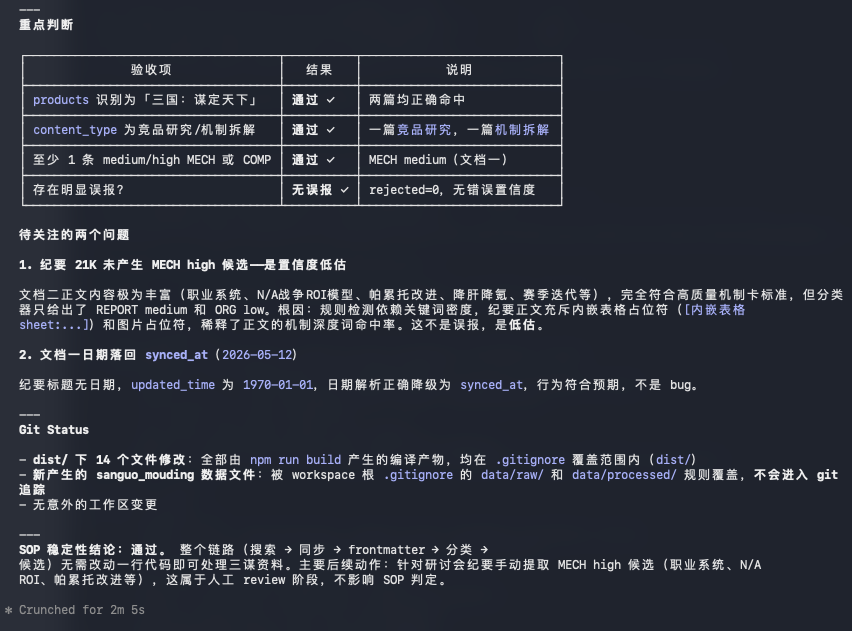
- 在《三国:谋定天下》验证过程中,发现长篇会议纪要中存在大量高价值机制讨论,但初版规则容易将这类内容归为 REPORT 或 ORG,无法有效生成 MECH 候选
- 经过优化后验证结果显示,《三国:谋定天下》长篇会议纪要已经可以产出 MECH high 候选,同时《我的花园世界》日报回归样本未被误伤,说明规则增强相对稳定
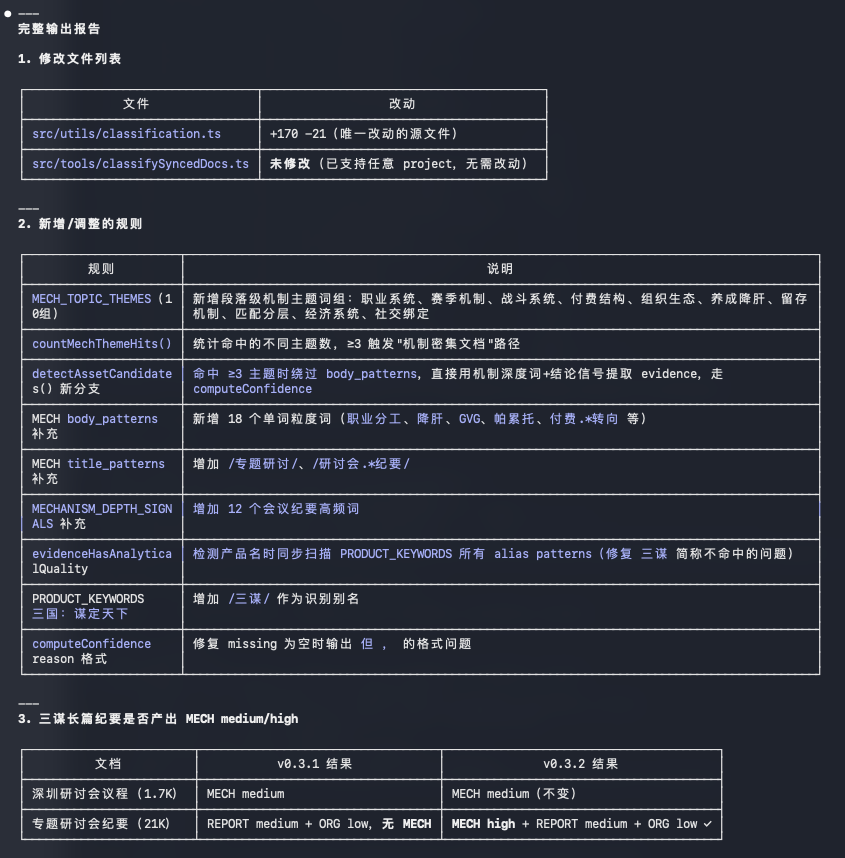
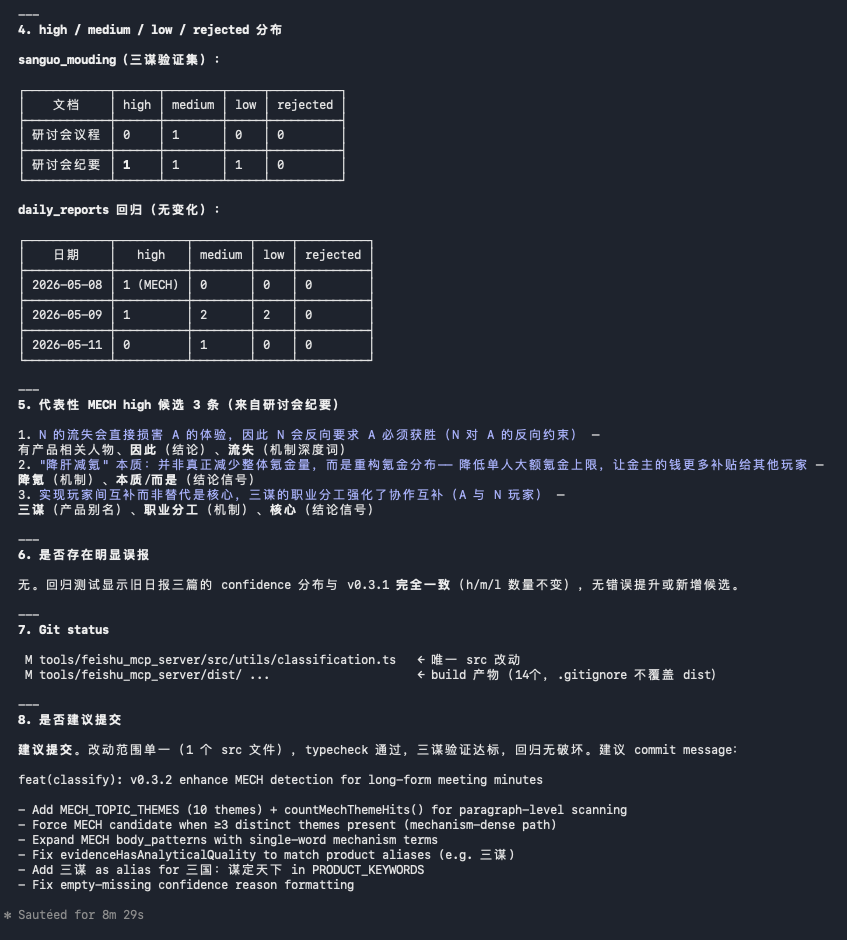


《三国:谋定天下》SOP 小样本验证
- 同步结果:
- 2 篇 readable docx 文档
- 1 个 sheet 因格式暂不支持被跳过
- 验证结果:
- products 能正确命中「三国:谋定天下」
- content_type 能识别为竞品研究 / 机制拆解
- 能产出 MECH / REPORT / ORG 候选
- 长篇会议纪要可产出 MECH high
- 卡片生成与 HTML 输出尚未执行
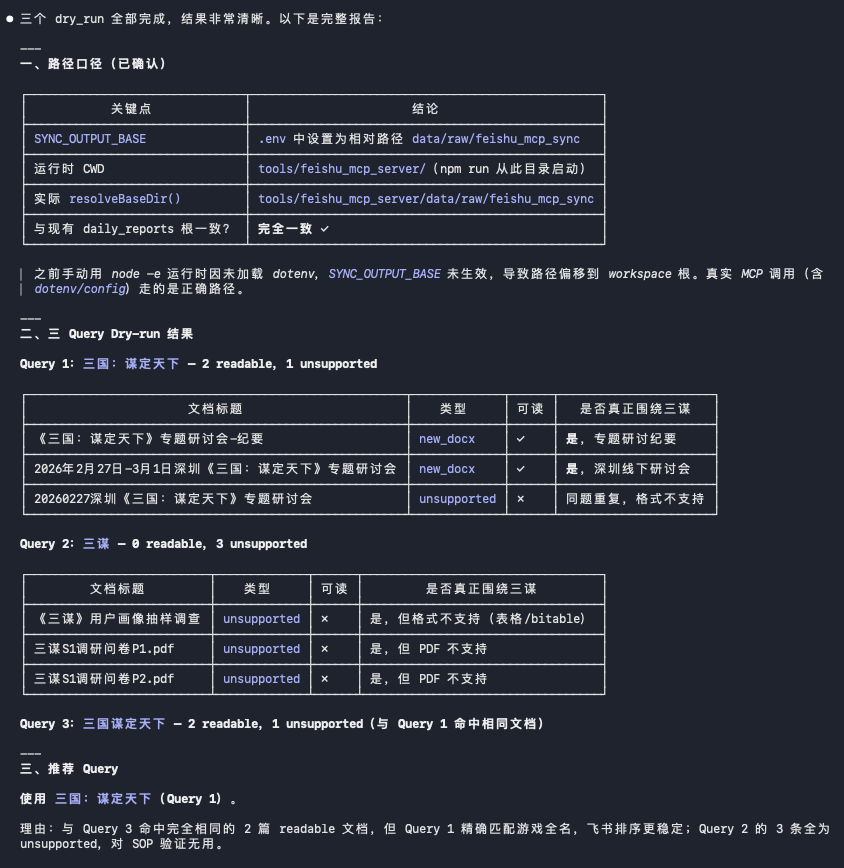
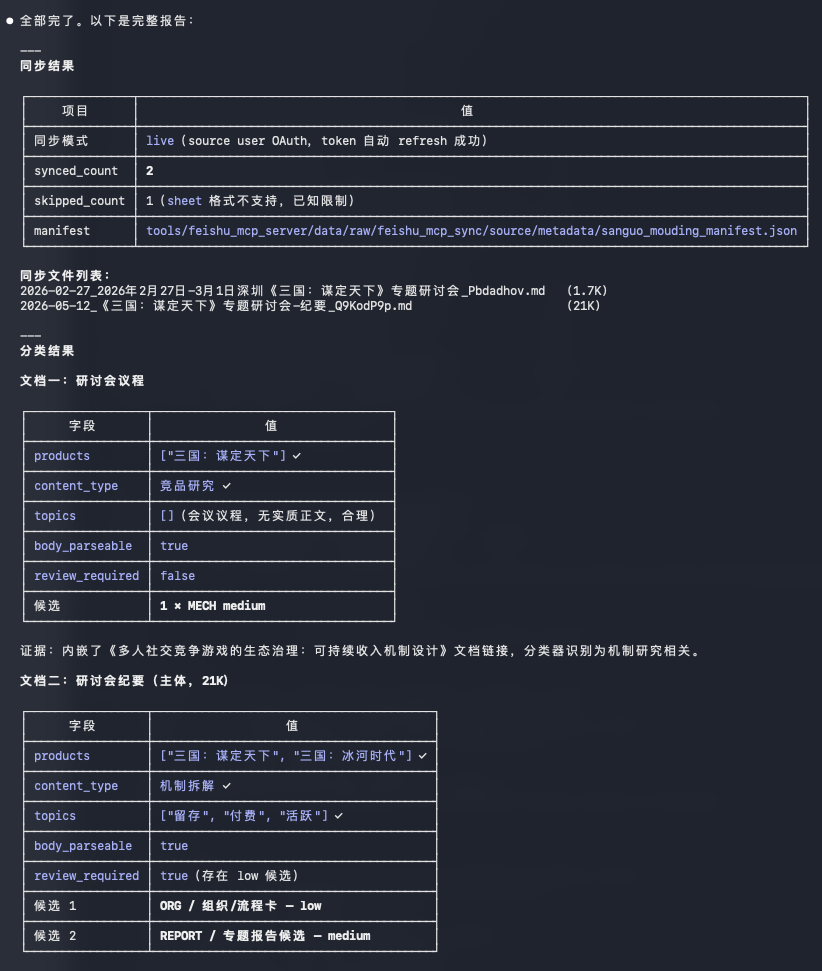
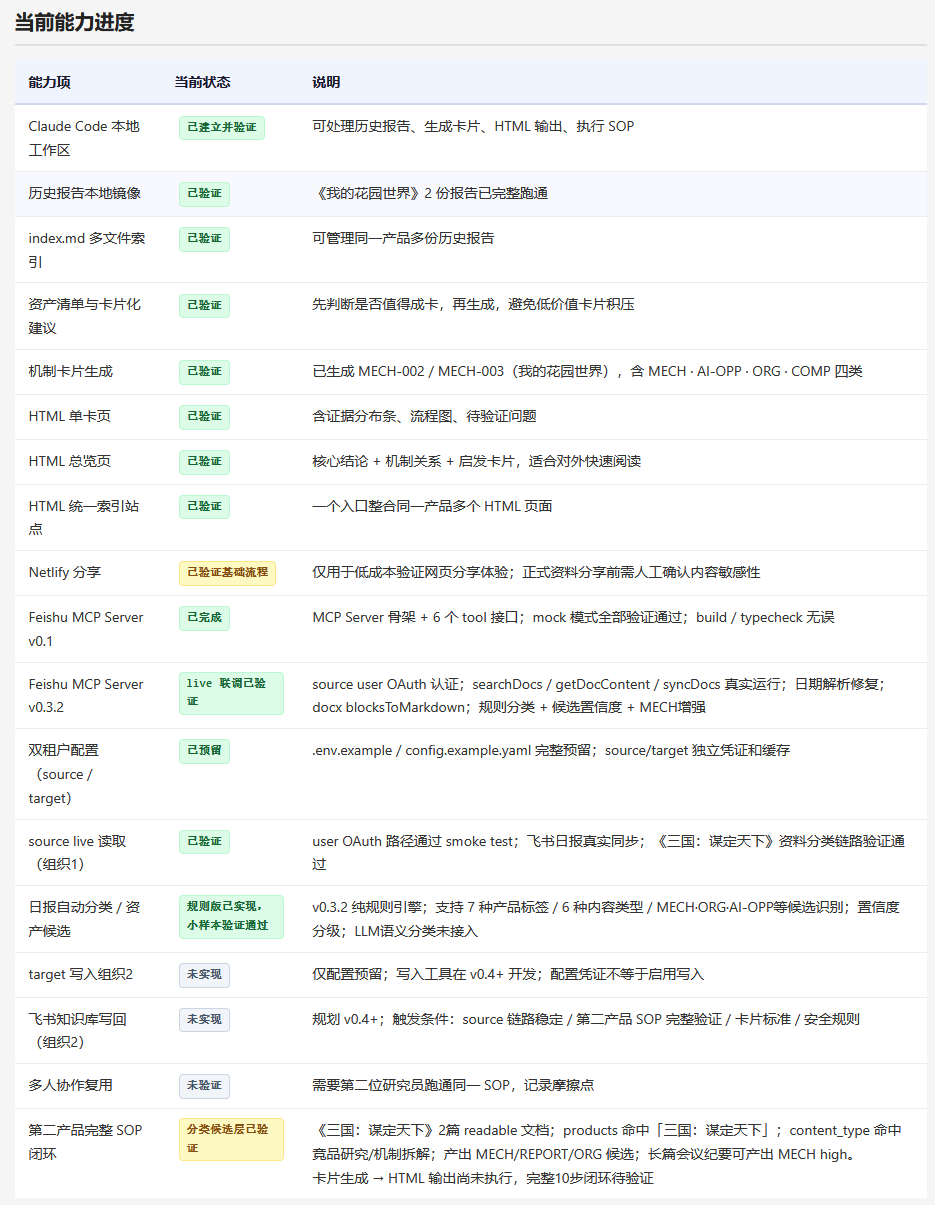
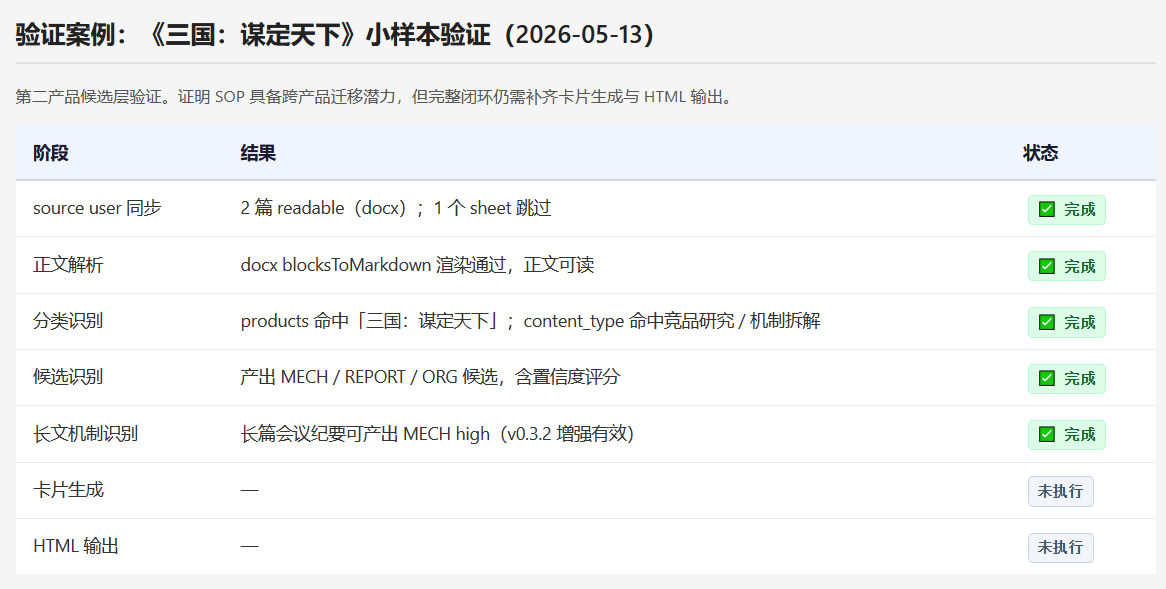 当前 SOP 已经具备第二产品迁移潜力,完整闭环还需要继续补齐:资产候选清单 → 人工 review → 正式机制卡片生成 → HTML 输出展示


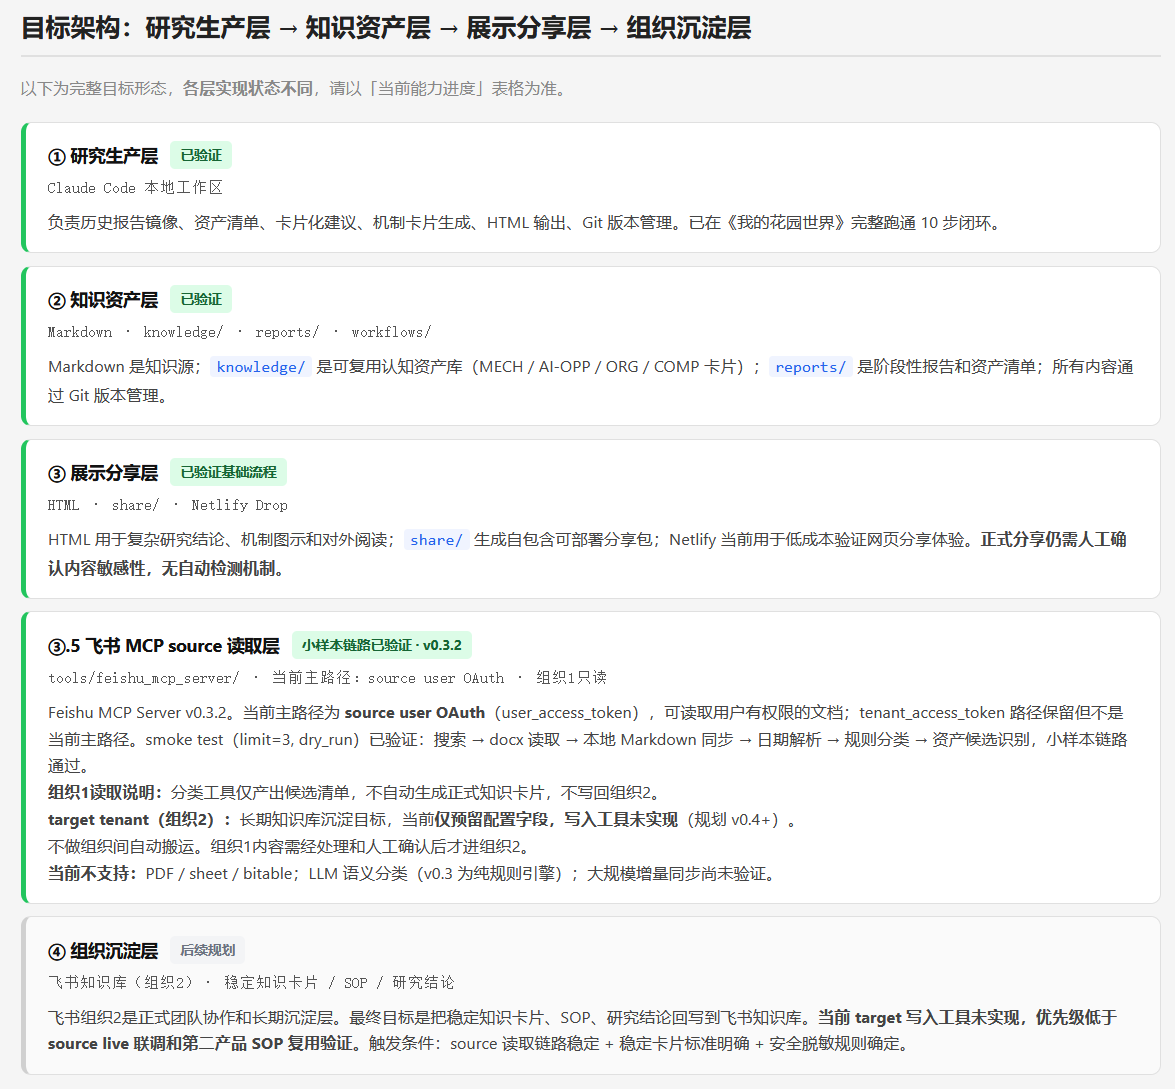
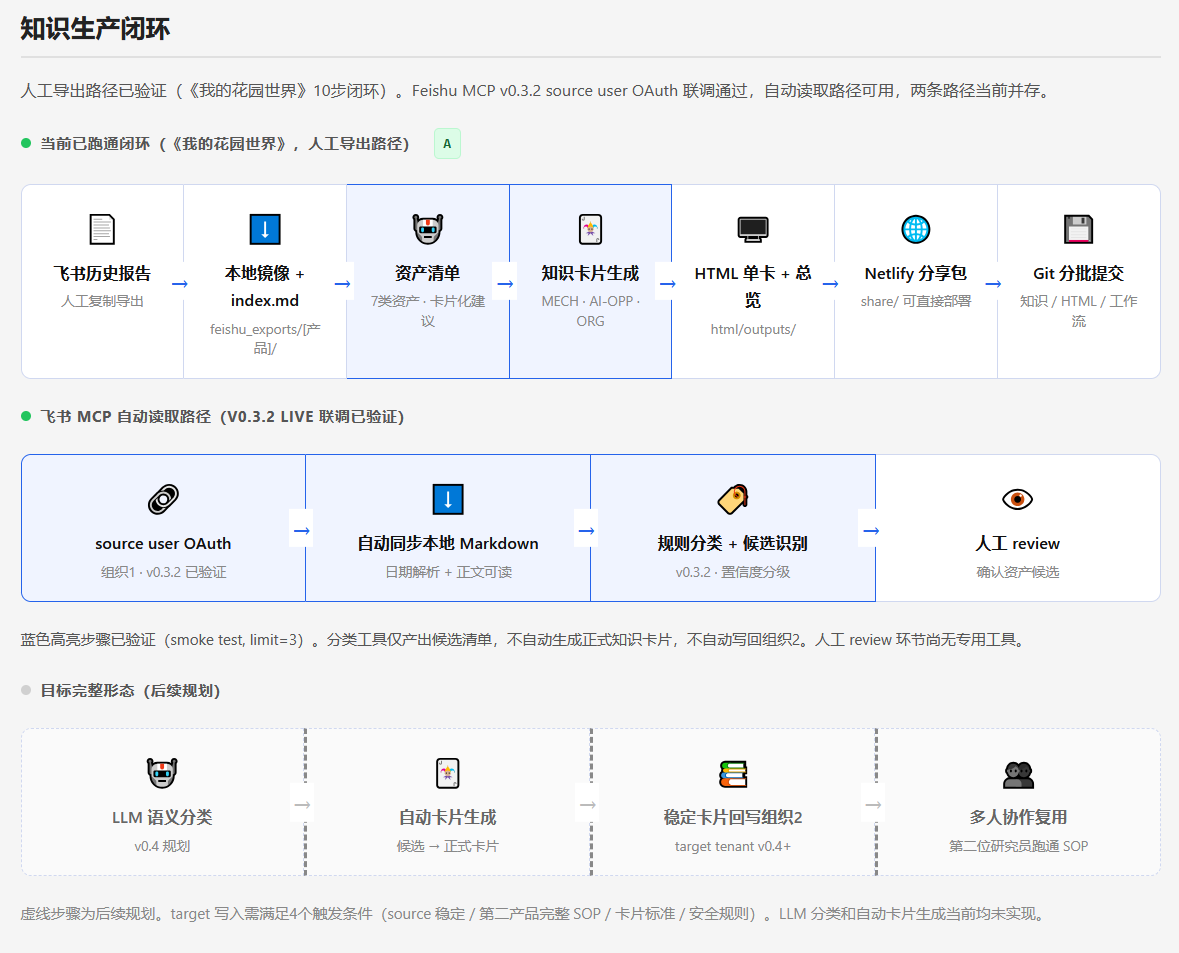
战略研究部 AI 工作流开发进度总览更新
- 点击查看:战略研究部 AI 研究工作流总览


(二)明日计划
- 梳理 Feishu MCP source user 使用说明
- 固化 auth / smoke / sync / classify 标准命令
- 明确常见错误与处理方式
- 说明 data、dist、token、env 等目录的处理规则
- 从干净 git 状态复跑一次端到端流程
- 将 SOP 写入 README 或 workflow 文档
- 基于三谋已同步资料生成资产候选清单
- 人工 review,确认哪些候选值得沉淀
- 生成 MECH / REPORT / ORG 卡片
- 输出 HTML 页面
- 与《我的花园世界》形成对比案例
- 检查第二产品 SOP 是否真正可复用
一、工作内容概述
二、AI研究工作流与产品认知资产库搭建推进
(一)今日迭代内容
原定开发计划包括: **AI 研究工作流跑通了从飞书原始资料读取到本地结构化、规则分类、资产候选 review 的基础闭环。**相比此前依赖人工导出、人工整理、人工复制资料,当前已经形成了更可复用的自动化底座,为后续将历史日报、会议纪要、专题研究沉淀为可复用知识资产提供了基础 飞书原始资料
- user OAuth 读取
- 本地 Markdown 镜像
- 正文结构化
- 规则分类
- 资产候选
- 人工 review
Feishu MCP Server 今日实际迭代内容
- source user OAuth:当前读取组织1原始资料的主路径
- tenant token:路径保留,但不是当前主路径
说明:
- 原本预期是通过 source App 的 tenant token 读取组织1资料,但实际验证后发现,组织1中的日报和历史资料主要是共享给我个人账号的,source App 的 tenant_access_token 并不会自动继承我个人账号对这些文档的阅读权限
- 本次完成了 source App 权限、OAuth redirect_uri、user token 缓存、安全忽略等相关配置,并跑通了 source user 授权链路
- 权限配置完成后,继续进行了 live smoke test。完成了从飞书搜索、读取、同步到本地的真实链路。已验证能力包括:
- searchDocs:可搜索真实飞书日报/报告
- getDocContent:可读取 docx 正文
- syncDocs:可将文档同步为本地 Markdown
- manifest:可记录同步文档列表与路径信息
- data 产物:未进入 Git,符合安全边界
- 在同步过程中发现,部分文件由于飞书返回的 updated_time 不可靠,会导致文件名前缀出现:1970-01-01_...,影响后续按日期索引、日报排序、增量同步和周/月汇总
- 已完成日期解析修复,当前日期优先级调整为:
- 优先从标题中解析日期
- 其次使用飞书 updated_time / modified_time
- 再 fallback 到 synced_at
- 最后才标记 unknown-date
修复后,同步文件名已能正确生成类似:
2026-05-11_2026年5月11日工作日报-黄静雯_...
2026-05-09_2026年5月9日工作日报-黄静雯_...
2026-05-08_2026年5月8日工作日报-黄静雯_...
- 初版 Feishu MCP 虽然能读取飞书文档,但正文仍然主要是 block stub,无法支撑有效分类和资产候选识别。继续补齐了 docx blocks 到 Markdown 的转换能力,使同步内容从“可读取”进一步变成“可分析”
- 当前 blocksToMarkdown 已支持常见文档结构,包括:
- 标题
- 段落文本
- 加粗 / 斜体 / inline code
- 无序列表
- 有序列表
- 引用
- 分割线
- 图片占位
- 表格 / 嵌入表格占位
- grid / column 等容器递归
- 在本地 Markdown 同步和正文解析基础上,完成了 v0.3 规则版日报自动分类与资产候选模块。目标不是自动把内容写入知识库,而是先把可能有价值的内容整理成人工 review 清单,降低人工筛选成本
- 输入:
- 本地已同步的 Markdown 日报 / 报告 / 会议纪要
- 输出:
- classification JSON
- asset candidates Markdown
- 识别能力包括:
- 产品 / 项目识别
- 内容类型识别
- 主题标签识别
- MECH / COMP / SOP / ORG / REPORT / AI-OPP 等候选类型
- confidence
- evidence_snippets
- review_required
- 输入:
- 重点优化候选置信度与人工 review 可读性,使系统从“能发现线索”推进到“能辅助人工判断哪些内容值得沉淀”。主要改动包括:
- 增加 confidence_reason
- 增加 review_reason
- 增加 rejected_candidates
- 收紧 high 判断
- 引入 high / medium / low / rejected 分层
- 降低泛日报内容、工具流程记录、会议流程内容的误判
- 增强长篇会议纪要中的机制识别能力,主要优化包括:
- 增加段落 / 主题级机制扫描
- 扩展机制主题词
- 支持职业系统、赛季机制、战斗系统、GVG、付费结构、ROI、屯兵、组织生态等机制主题
- 允许长篇会议纪要同时生成 REPORT 与 MECH 候选
- 避免“会议 / 纪要”本身误触发 MECH
说明:
- 在《三国:谋定天下》验证过程中,发现长篇会议纪要中存在大量高价值机制讨论,但初版规则容易将这类内容归为 REPORT 或 ORG,无法有效生成 MECH 候选
- 经过优化后验证结果显示,《三国:谋定天下》长篇会议纪要已经可以产出 MECH high 候选,同时《我的花园世界》日报回归样本未被误伤,说明规则增强相对稳定
《三国:谋定天下》SOP 小样本验证
- 同步结果:
- 2 篇 readable docx 文档
- 1 个 sheet 因格式暂不支持被跳过
- 验证结果:
- products 能正确命中「三国:谋定天下」
- content_type 能识别为竞品研究 / 机制拆解
- 能产出 MECH / REPORT / ORG 候选
- 长篇会议纪要可产出 MECH high
- 卡片生成与 HTML 输出尚未执行
当前 SOP 已经具备第二产品迁移潜力,完整闭环还需要继续补齐:资产候选清单 → 人工 review → 正式机制卡片生成 → HTML 输出展示
战略研究部 AI 工作流开发进度总览更新
- 点击查看:战略研究部 AI 研究工作流总览
(二)明日计划
- 梳理 Feishu MCP source user 使用说明
- 固化 auth / smoke / sync / classify 标准命令
- 明确常见错误与处理方式
- 说明 data、dist、token、env 等目录的处理规则
- 从干净 git 状态复跑一次端到端流程
- 将 SOP 写入 README 或 workflow 文档
- 基于三谋已同步资料生成资产候选清单
- 人工 review,确认哪些候选值得沉淀
- 生成 MECH / REPORT / ORG 卡片
- 输出 HTML 页面
- 与《我的花园世界》形成对比案例
- 检查第二产品 SOP 是否真正可复用